
【资料分享】谢治宇:工业人工智能技术如何赋能智能制造发展
今天,我主要想跟大家分享一下我们在人工智能领域取得的最新进展。首先,我会简要介绍一下当前人工智能的发展历程。特别是在大模型风靡各行各业的背景下,我们该如何看待当前的形势?
▲谢治宇 成都考拉悠然科技有限公司首席架构师
什么是人工智能?这个话题其实在1956年就被提出来,大家熟知的就是图灵实验,能不能让机器像人一样去思考,这就是人工智能最开始的雏形。各位专家在这个过程中可能会听到模型、大模型。那么模型是什么东西?其实很简单,我们初中、高中都学过,就是有一些数字,这些数字要预测它下一个会出现什么,它是一个函数。有一些数据要找到线性回归找到下一个模拟点,这根线就是函数,最简单的函数。有了这个“函数”,就可以预测下一个X是多少,Y是多少。这是极其简单的,即使现在大模型的架构,它的本质也是要找到这样的函数。所有的人工智能目前都可以用数学的方法解释它。
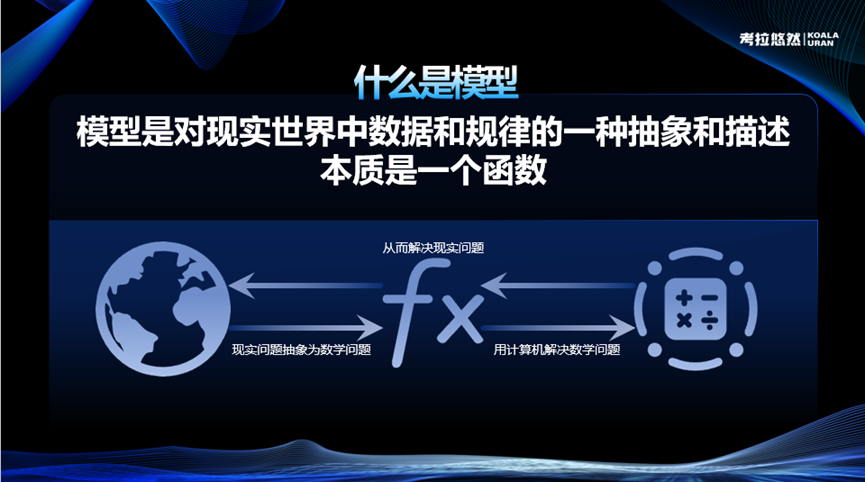
无论是过去还是现在,人工智能本质上都是在寻找这样的函数。即使是目前复杂的大模型,其核心也是为了找到一个能够描述数据之间关系的函数。所以说,所有的人工智能都可以用数学的方式来解释。
大模型,比如图像识别,这个就是我们提供给模型学习的图片。这个就是我们的CNN神经网络,在没有被训练之前,它看起来是这样的,训练之后它就变成了最右边的样子。所谓的训练,就是找到如何表征这张照片的特征,比如它是某个人。这个就是训练的过程,需要大量的数据。人工智能本质上是一个大力出奇迹的过程,包括这样一个结构,它用各种数据来判断你像不像某个人,或者哪一个模型最先找到最优解,这就是一个训练过程。
现在大家熟知的图像识别也好,语音识别也好,还是像阿尔法狗一样去做这种规划,深度学习的本质原理就是这个。有了这个原理之后,我们来讲大模型。在模型参数量方面,我刚才说的参数就是用来表征这张照片、这个概念或者它们之间的关系是什么。这个参数的量级是远远超过人脑所能认知的。比如我们看一本300页的书,现在语言大模型能够定量地解释出这本书第一个字和最后一个字的关系,但是人永远没有办法理解这么高维度的信息。我只知道这本书里面描述了一个事件和一个人有关系,从一个词、一个字来讲,完全不能理解。但是现在大模型就能做到这一点,这得益于大量的参数。
这种参数增大之后,不管是突然发现2022年GPT推出的时候,还是大家现在使用的ChatGPT,或是国内的文心一言这些,就会发现它会涌现一种能力,一些它原来没有学过的知识也能表达和转移出来。这就是大模型的能力。
现在通用模型用得比较多的是智能问答,相信在座各位对大模型也并不陌生,比如写一篇文章、查询一个问题、让它输入一份报告,它做起来非常得心应手。还有一些图像的处理、视频的理解,这些都是大模型现在特别擅长的一些领域。
大模型是一个通才,人类要有这种意识:我们现在做这一行就深刻意识到大模型的能力是远远超过任何一个单独的人类个体的能力,不管你是哪个方面的专家。因为它学习知识的效率非常快,而且也不会感到疲劳,它可以7×24小时不停地学习,是能够学完的。在ChatGPT发布第一个版本的时候,下面有一行小字就写着,所有这些知识已经把人类截至2021年9月份以前的所有知识全部学完,这就是大模型最大的一个能力。
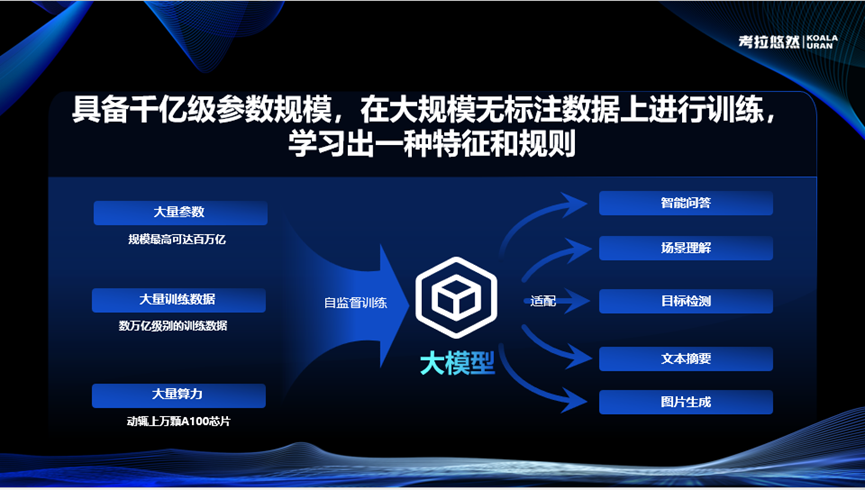
有了这些以后,我们会发现像ChatGPT为代表的最强大模型,在写代码和内容创作方面,以及在理解和生成物理客观世界方面,甚至展现出了非常优秀的能力。
有了它以后,现在掀起了新一波的热潮,就是从ChatGPT开始,比尔·盖茨就说这个不亚于互联网的诞生,它象征着iPhone时代的到来,但是在我看来远远不仅于此。现在我们仅仅是看到了一条通向AGI(通用人工智能)的可达技术路径。但是,以ChatGPT为代表的Transformer这种模型结构不一定是最终的形态。
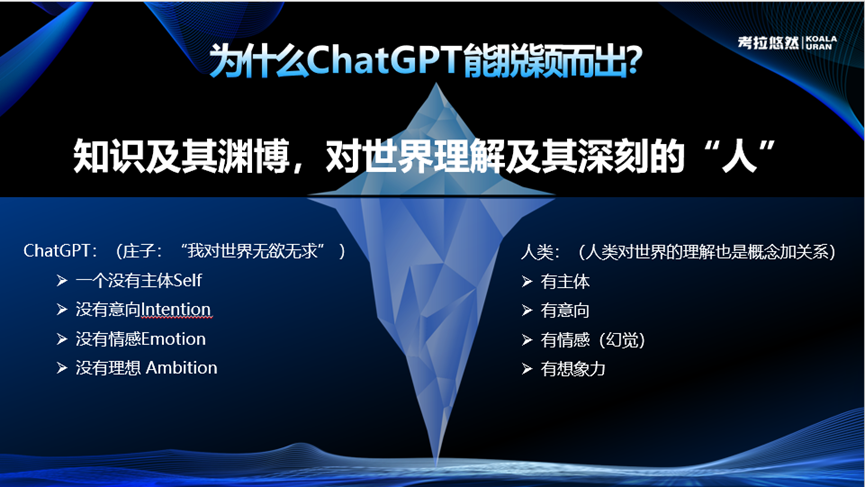
我们来看ChatGPT为什么能脱颖而出。我们在冰山上看到的是ChatGPT的能力,实际上下面有很多支撑。为什么世界上现在只有OpenAI这家公司能训练出地表最强的模型,它的人才是核心。同时,动不动就是万卡集群,那对钱和能源的依赖都是非常大,不是你想去做就能做的。还有它拥有海量的知识,以及对数据的处理能力。
ChatGPT或者大模型究竟为什么这么强?用庄子的一句话讲,就是它对世界“无欲无求”,但它就是没有主体,没有意向,没有情感,也没有理想,除此以外,它超越了所有的人类。我们人还能站在这个地方去做一些创新,不外乎我们有主体,有意向,有情感,还有想象力。但是这些每个月都在发生变化,因为我们所谓的模型幻觉不就是它的想象力吗?如果有一天大模型具备意识以后会是什么样子?现在DeepMind和OpenAI发布了AGI的5个等级。真正到L5的等级可能就是另外一个界面了。但是我们这一辈人不用担心,还不会来得那么快,它或许是一个知识极其渊博,对世界理解非常深刻的“人”。
有了这些技术,我们在产业领域进行了哪些探索呢?如何将这些能力转化为实际的产品和应用,从而赋能于造纸行业乃至各行各业?接下来,我将为大家详细介绍。
刚才我们提到,人工智能是一场技术革命,同时也在推动产业的变革。值得一提的是,国家也出台了一系列政策支持人工智能的发展,比如四川创新1号工程。从国家到地方政府,都在积极推动人工智能,尤其是大模型的发展。那么,大模型为何能引发如此巨大的产业变革呢?
刚才在外面看到有做智能检测纸张表面的外观质量检测,其实我们以前也做智能检测,基于玻璃面板和半导体,它就是一个传统的视觉和深度学习,甚至机器学习的方法。但是我们用在纸上和用在半导体上是完全不同的场景。以前确实是要用场景化的数据去训练纸张表面检测和半导体检测。现在2.0时代,模型衍生驱动了生产方式,我仅仅需要告诉模型现在看的是纸,是半导体,它就这样进行泛化和牵引,这就是我们对产业端带来最大的变革。
现在大模型的发展趋势,其实所有的人类终极梦想或者说我们想做人工智能的终极梦想是实现AGI,即通用人工智能。但我们现在才处于第二个阶段,从原来的感知智能,也就是传统的深度学习,到现在有了一定的认知能力,我们称之为认知智能或者多模态的能力。下一步它要做的是自主智能,它可以自己做任务规划,而不是需要人去告诉它现在要做什么任务。再下一步就是群体智能,智能体之间可以进行对话和交流。到了那一天,我们和AI的关系,和人工智能的关系,就像科幻片里面讲到的,我们就得去考虑一下它对人类的威胁。但是这个如我所说还早,至少在我们这一代还看不到。
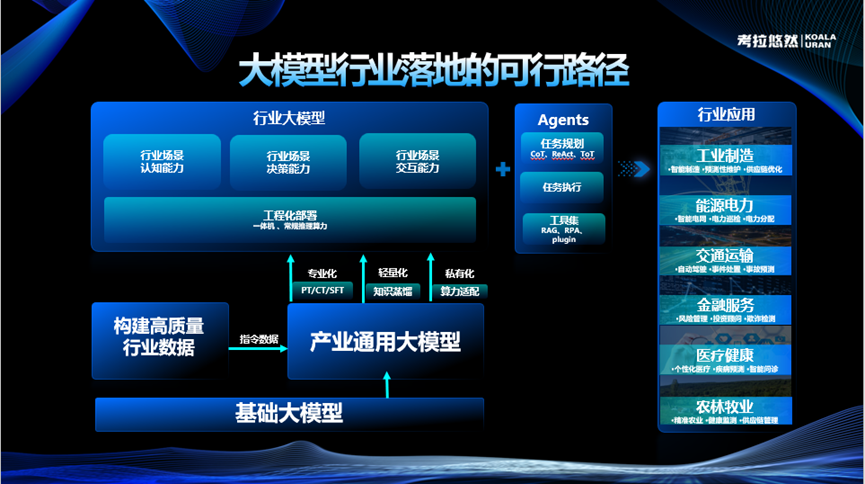
下一个话题就是我们刚才讲了很多关于通用大模型的能力。去年的百模大战中,各个大厂包括大模型的“六小龙”都在竞争通用大模型。但是,当真正要应用到行业端,特别是要在产业端产生影响时,它必须变成一个行业大模型。只有行业大模型的成本和能力才能足够专业。通用模型是一个通才,但在产业端和具体行业中,我们需要的是专才,不需要它写诗作画,只需要它在造纸行业发挥作用就可以了。因此,趋势是要做行业大模型。
还有比拼能力,过去大家关注的是参数量有多大、上下文有多长,但到了今年,大家都在关注是否有成熟的行业落地,也就是是否有实际的行业应用。这就是当前大模型发展的趋势。我再分享一下行业落地的一些思路和案例。
首先,为什么那么难?既然基础模型需要投入那么多资金和巨大的算力,为什么大家还要去做基础模型?大家都在做不同专项行业模型,但在行业落地时面临很多挑战,成本是一个问题,门槛也是一个问题。这个技术门槛不仅涉及到我们这些从事AI技术开发的人,也包括使用者。你们需要把刚才所讲的这些造纸的东西告诉我这个外行,告诉我造纸需要这个东西,这个沟通成本都是很高的。所以,无论是对我,还是对你们来说,都是很高的技术门槛。还有行业壁垒很高,这里面很多工艺流程都是大家最宝贵的生产资料,所以它不是那么容易能够拿出来让模型去学习的。
基于此,我们提出了一个可行的路径。考拉有一个基础模型,这个基础模型不是L0级别的,像智谱和GPT这样的基础模型,而是我们积累了很多行业数据后,做的一个产业通用的大模型。它是一个多模态的大模型,能够对语言、文字、视频等各种模态的数据进行对齐学习、处理和理解。有了这个基础模型之后,我们可以通过平台打造行业应用。这就是我们提出的行业模型加Agent,最终实现行业应用的落地。
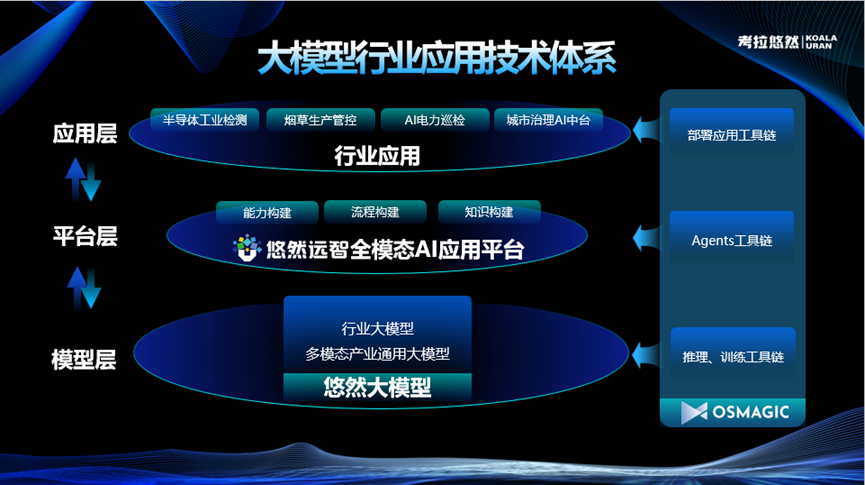
这是基础的技术平台,有了它之后,我们进行了一些实践。依托于刚才提到的技术领先优势,我们专注于两类核心业务。一类是平台业务,我们将这一套生产工艺和流程分享出来,使得大家可以在这个平台上根据自己的业务需求,自行定义业务模式和业务模型,进而开发行业应用。
我们还在自主地开展从0到1或者一竿子插到底的行业应用。目前我们涉足较多的领域包括半导体、烟草,烟草可能和造纸有些相似之处。此外,还有交通、电力等场景。我们将上述一系列技术沉淀成一个平台,即全模态AI应用平台。有了这个平台之后,大家可以基于自己的数据和场景,再结合大模型的能力——也就是我们提供的行业大模型的能力,在造纸的某一个细分场景中打造一个行业大模型应用,实现落地。
在今年9月份,我们刚刚举办了一次发布会,会上发布了悠然大模型的基础模型能力。首先,是视频对话能力,这类似于GPT,能够实时进行视频对话,通过画面中看到的内容来回答问题,这就是视频理解能力。其次,是要素解析能力,它能够像人一样,比如在今天的会场放一个摄像机,就可以全程参与会议,像秘书或速记员一样,把里面所有发生的事情和对话全部记录下来。
此外,我们还进行了一些事件的溯因分析,这在交通场景和烟草生产中应用较多。如果发生了事故,需要查看它是如何发生的,可以主动调阅之前的录像,就像人一样去分析事故原因。例如,我会查看你在事故发生前10秒或30秒做了什么。此外,我们在汶川进行了科技部的一个课题研究。汶川地震后,当地已经面目全非,我们现在通过各种视觉数据去恢复它震前的样子,有了这个技术后,可以辅助救援力量进行生命体的探测。基于我们刚才提到的平台,就可以快速打造行业应用。
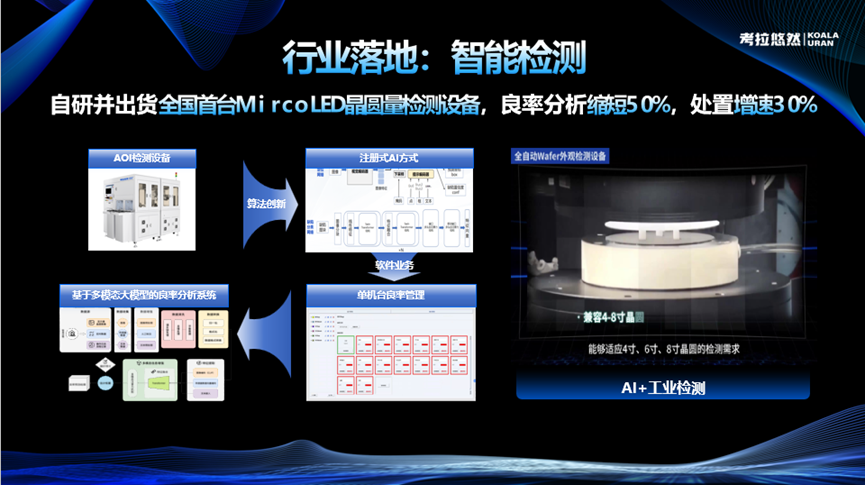
最后,我分享一些案例。这些案例与造纸行业的关系较为密切,主要是外观检测。缺陷检测主要应用在两个方面:一是手机面板的亮灯检测和点胶检测,京东方和新黎会科等企业正在开展这方面的工作。二是半导体领域,我们上个月刚交付了全国第一台micro晶元检测设备。这是它的演示视频,我们在双流有一个工厂。我们使用大模型进行检测,同时也采用了传统的深度学习视觉方法,我们将所有的检测数据汇总在一起,通过一个ADC平台进行溯源处理,以指导工艺生产。
我们在烟草行业进行了一些工作,虽然造纸行业目前还没有涉及,但和烟草行业有一些相似之处。我们目前正在做的是因果追溯。通过大模型,我们学习了烟草的生产工艺、生产流程,以及设备的维保记录和设备说明书。学习之后,我们可以通过结果,比如发现烟盒或烟杆的缺陷,倒推出在哪个工艺环节出现了问题,并输出一个针对性的解决方案。这样,就把以前老工人、老专家头脑中的知识具体化,让新手能够快速处理这些问题。
还有在交通方面的案例,这个跨度比较大。这是我们与蜀道集团合作的项目,就像人一样进行交通事故的认定以及决策如何处理,分析交通事故是如何发生的,需要采取什么方式进行救援,或者是否需要调动救援力量,这些都是通过我们的视觉理解能力来实现的。
我今天的汇报就到这里,希望通过这次交流探讨一下人工智能技术在造纸行业是否有赋能的可能性。